Event Sourcing speichert Änderungen als unveränderliche Events statt nur den aktuellen Zustand. Dieser Beitrag zeigt, wann sich der Ansatz lohnt, welche zusätzliche Komplexität entsteht und wie sich Event Streams und Projections mit Azure Cosmos DB umsetzen lassen.
Stell dir einen Wartungsauftrag für eine Industriemaschine vor. Er wird geplant, während der Wartung werden Teile ausgetauscht und am Ende wird er abgeschlossen.
In einer klassischen Anwendung siehst du meist nur den aktuellen Zustand, nicht den fachlichen Ablauf, der dorthin geführt hat.
Event Sourcing hält fachliche Änderungen als unveränderliche Events fest und leitet den Zustand daraus ab.
Ob sich der zusätzliche Aufwand lohnt, hängt davon ab, ob dieser Verlauf deiner Anwendung einen konkreten fachlichen Wert liefert.
Am Beispiel zeigen wir, wie du Event Streams und Projections mit Azure Cosmos DB for NoSQL modellierst und welche Betriebsaufgaben hinzukommen.
Was ist Event Sourcing?
Event Sourcing ist ein Architekturmuster, bei dem eine Anwendung ihren fachlichen Zustand aus gespeicherten Events ableitet.
Ein Event hält fest, was bereits passiert ist, beispielsweise dass ein Teil gewechselt oder ein Auftrag abgeschlossen wurde.
Die Events sind die maßgebliche Datenquelle, aus der die Anwendung den aktuellen Zustand berechnet.
Bei zustandsbasierter Speicherung überschreibst du beim Abschluss des Wartungsauftrags das Statusfeld mit dem neuen Wert.
Bei Event Sourcing fügst du stattdessen ein Event hinzu, das den Abschluss festhält.
Um den Status zu ermitteln, wertet die Anwendung die bisher gespeicherten Events des Auftrags der Reihe nach aus.
Die Anwendung kann den daraus berechneten Zustand zusätzlich speichern, muss ihn aber aus den Events wiederherstellen können.
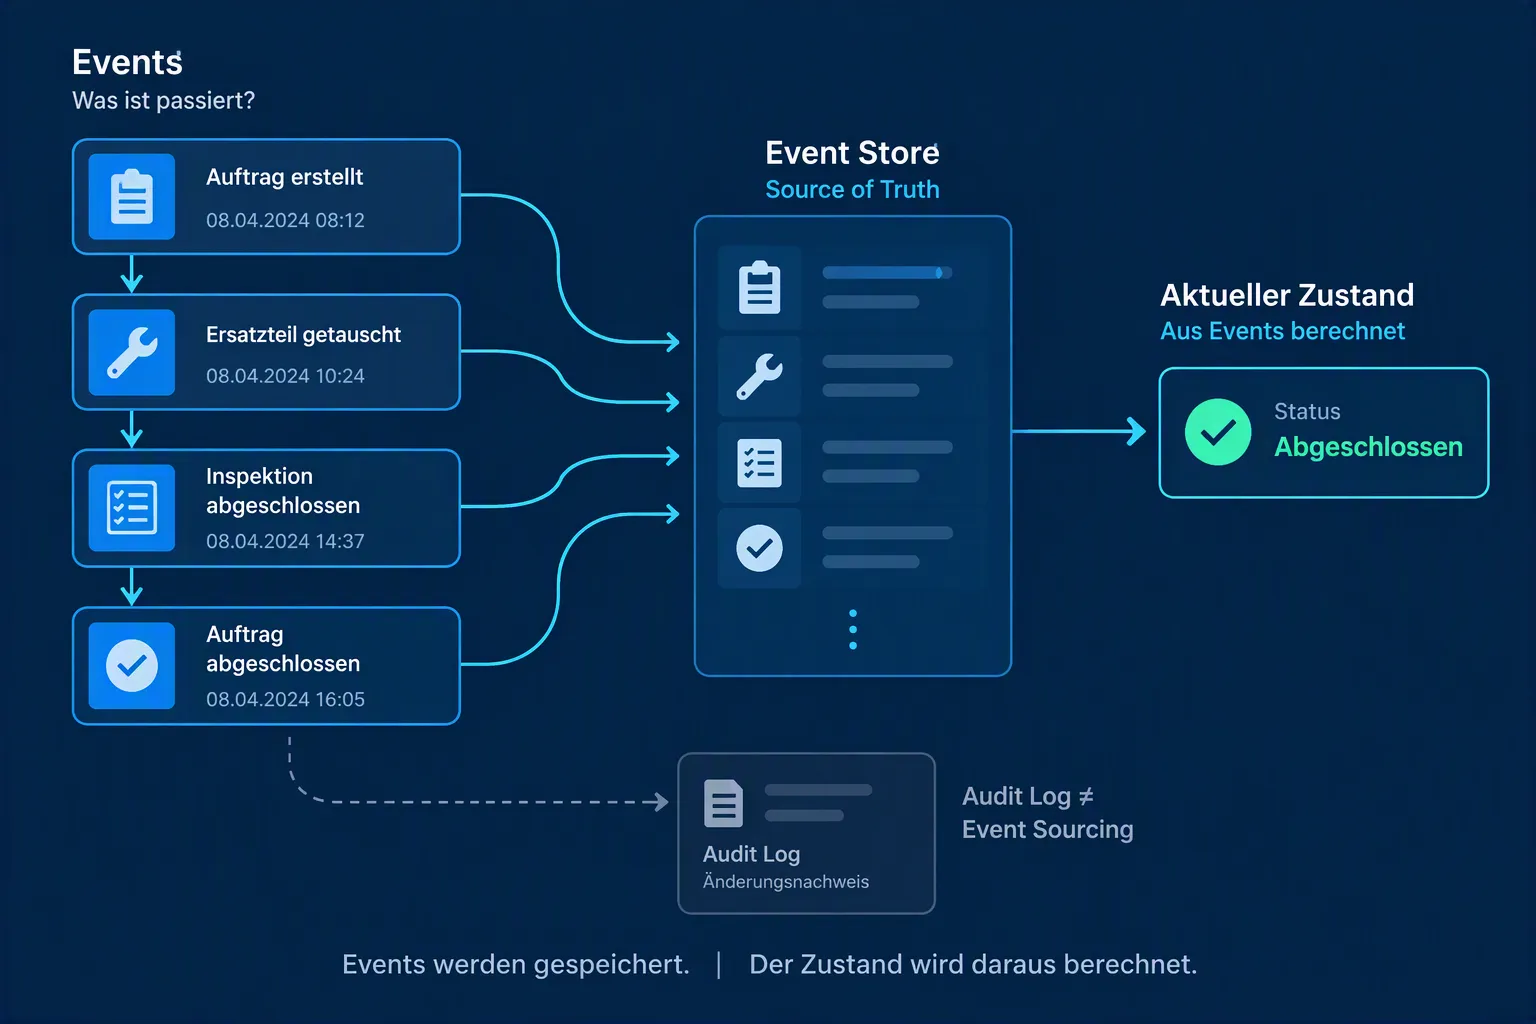
Ein Audit-Log macht eine Anwendung deshalb noch nicht zu einem Event-Sourcing-System.
Es ergänzt den gespeicherten Zustand um einen Änderungsnachweis, während die Anwendung weiter mit diesem Zustand arbeitet.
Wenn du nur Status und Abschlussdatum sowie gelegentlich einen Änderungsnachweis brauchst, bleibt ein Zustandsmodell mit ergänzendem Audit-Log oft einfacher.
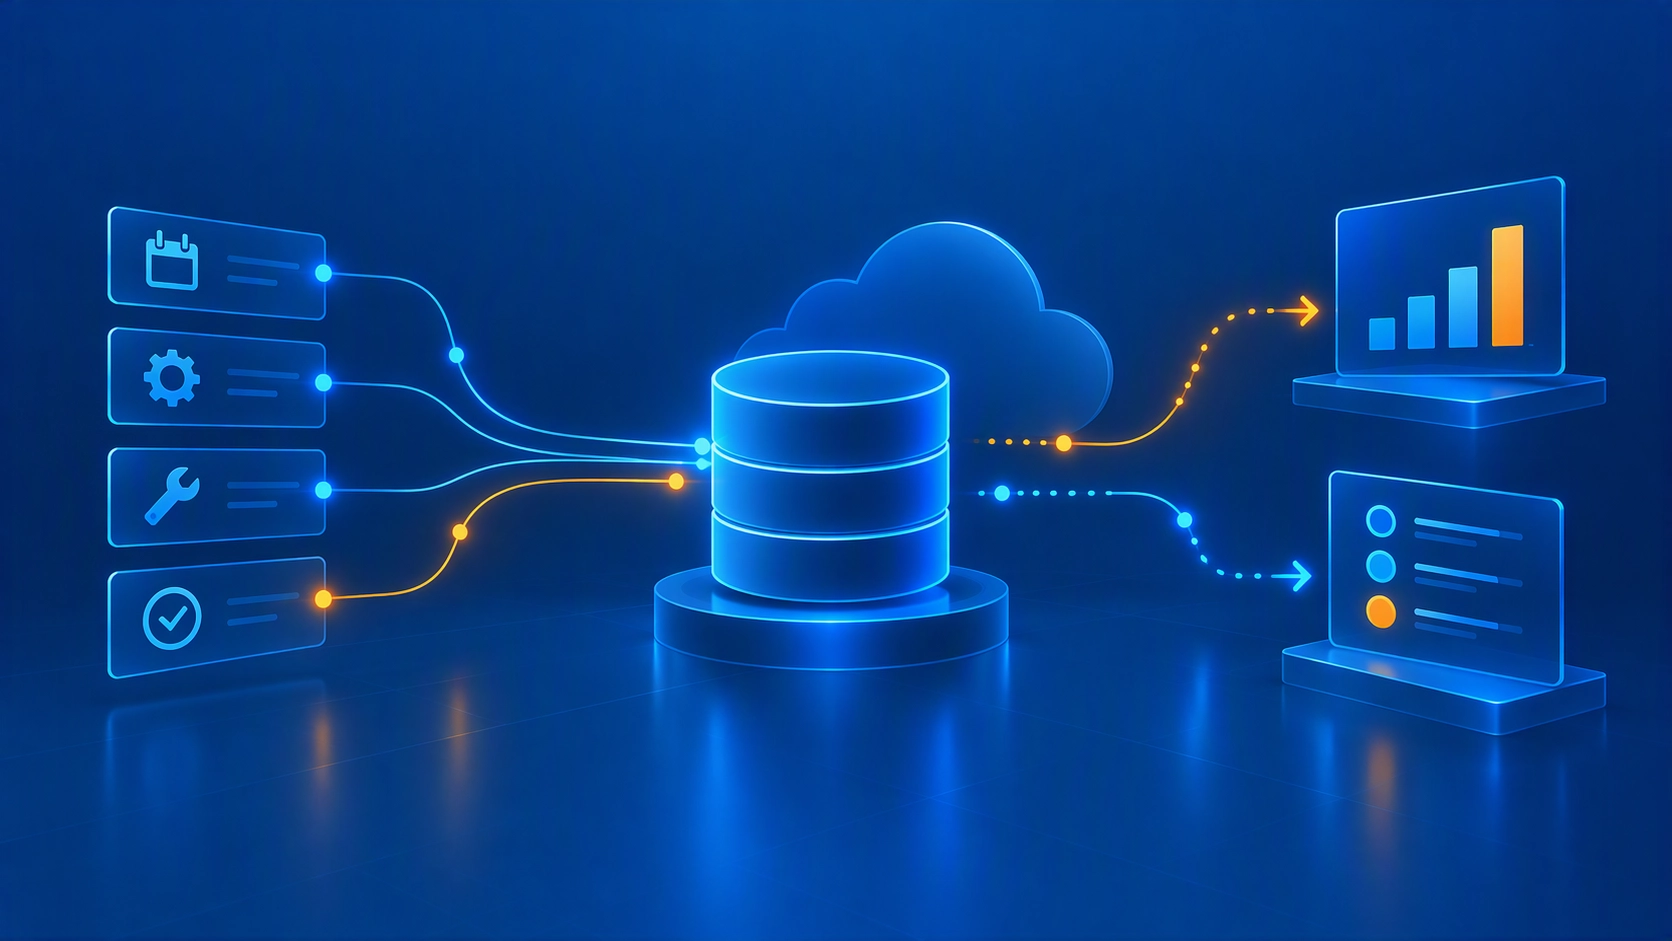
Die Grafik zeigt das Event-Sourcing-Modell am Wartungsauftrag. Der Event Store bewahrt die fachlichen Ereignisse, aus denen die Anwendung den aktuellen Zustand ableitet. Ein Audit-Log allein bildet dieses Modell nicht ab.
Event Stream, Aggregate und Rehydration
Unser Fokus liegt auf dem Wartungsauftrag. Er ist in diesem Beispiel das Aggregate und bündelt die Auftragsdaten sowie die fachlichen Regeln für Änderungen am Auftrag.
Für jedes Aggregate gibt es einen eigenen Event Stream. Dieser enthält die vollständige fachliche Historie des Wartungsauftrags als geordnete Folge von Events.
Der Wartungsauftrag beginnt mit einem MaintenanceScheduled-Event.
Wird ein Teil gewechselt, kommt das PartReplaced-Event hinzu.
Beim Abschluss hängt die Anwendung ein MaintenanceCompleted-Event an.
Jedes Event beschreibt eine fachliche Tatsache, nicht bloß einen neuen Feldwert.
Diese Folge wird dauerhaft im Event Store gespeichert. Um den aktuellen Zustand zu erhalten, wendet die Anwendung die Events der Reihe nach an.
Diese Rekonstruktion nennt sich Rehydration.
Dabei erhält die Anwendung den aktuellen Status und die bisher gewechselten Teile.
Neue Events werden an den Stream angehängt, ohne bestehende Events zu überschreiben.
Wurde ein Teilewechsel irrtümlich erfasst, modellierst du die Korrektur als weiteres fachliches Event, statt das ursprüngliche zu überschreiben.
Um den Auftrag vor dieser Korrektur zu rekonstruieren, wendest du nur die Events bis zur gewünschten Stream-Version an.
Die Microsoft-Dokumentation zum Event Sourcing Pattern beschreibt dieses Modell und seine Einschränkungen.
Einen Auftrag im Event Store speichern
Für die Events unseres Aggregates brauchen wir einen Event Store. In diesem Beispiel verwenden wir Azure Cosmos DB for NoSQL und speichern den Event Stream in einem Container.
Wir betrachten Single-Region Writes, bei denen alle Schreibzugriffe in einer Region stattfinden.
So beschränkt sich das Beispiel auf konkurrierende Commands, die denselben Stream aktualisieren.
Bei Multi-Region Writes können mehrere Regionen gleichzeitig denselben Stream ändern; die Konfliktauflösung für diesen Fall behandeln wir hier nicht.
Datenmodell und Reihenfolge
Für das Beispiel verwenden wir einen Container mit dem Partition-Key-Pfad /aggregateId.
Die aggregateId enthält die ID des Wartungsauftrags. Alle Dokumente desselben Auftrags, also Events und Stream Head, haben denselben Partition Key und liegen in derselben logischen Partition.
So kann Cosmos DB sie in einem Transactional Batch atomar schreiben. Unterschiedliche Aggregate-IDs bilden unterschiedliche logische Partitionen, die sich aber eine physische Partition teilen können.
Jedes Event bekommt ein eigenes Dokument.
Ein separates Dokument mit der ID stream-head hält die zuletzt bestätigte Stream-Version fest.
Beim Anlegen eines neuen Events liest der Handler diese Nummer und vergibt die nächste Version.
Die erste Event-Version ist 1; danach steigt sie mit jedem Event um 1.
Ein Command wie CompleteMaintenance fordert eine Änderung an.
Der Command Handler prüft diese Anforderung und erzeugt bei erfüllter Geschäftsregel das Event MaintenanceCompleted.
Im Event-Dokument speichern wir neben den fachlichen Daten die Stream-Version und die Kennung des auslösenden Commands.
Die aggregateId ordnet das Event dem Wartungsauftrag zu.
Die fortlaufende version legt seine Position im Stream fest und bestimmt die Reihenfolge, nicht der Zeitstempel.
Aus beiden Werten ergibt sich die Event-ID.
Über commandId identifizieren wir den auslösenden Command.
Die Kennung bleibt bei einer erneuten Zustellung desselben Commands gleich.
Der Stream Head trägt kind: "head", damit er sich bei der Verarbeitung von den Events unterscheiden lässt.
Zum Laden des Streams liest du die Event-Dokumente des Auftrags in aufsteigender version und lässt den Stream Head aus.
Der Stream Head dient der Kontrolle konkurrierender Schreibzugriffe, während die fachliche Historie weiterhin ausschließlich in den Event-Dokumenten liegt.
Stelle sicher, dass Event-Dokumente weder überschrieben noch durch eine Aufbewahrungsregel automatisch gelöscht werden.
Event und Stream Head atomar schreiben
Vor dem Abschluss eines Wartungsauftrags liest der Command Handler den Stream Head mit seiner Version und seinem ETag.
Er rekonstruiert den Auftrag aus den Events bis zu dieser Version und prüft, ob die Geschäftsregeln den Abschluss erlauben.
So trifft er die Entscheidung auf Grundlage des zuletzt bestätigten Standes.
Der ETag (Entity Tag) wird von Cosmos DB verwaltet und ändert sich, wenn das Stream-Head-Dokument aktualisiert wird.
Er unterscheidet sich von der fachlichen Stream-Version, die festlegt, an welcher Stelle ein Event im Verlauf steht.
Wenn die Geschäftsregeln den Abschluss erlauben, erzeugt der Command Handler das nächste Event und den neuen Stream Head, jeweils mit der um eins erhöhten Version.
Ein Transactional Batch speichert Event und Stream Head gemeinsam in derselben logischen Partition.
Schlägt eine Operation fehl, werden beide zurückgerollt.
Der folgende Ausschnitt zeigt diesen Schreibpfad für einen bereits vorhandenen Stream mit dem Azure Cosmos DB .NET SDK v3.
Er zeigt den atomaren Schreibpfad, nicht die vollständige Fehler- und Retry-Behandlung.
var batch = container.CreateTransactionalBatch( new PartitionKey(aggregateId));batch.CreateItem(nextEvent);batch.ReplaceItem( "stream-head", nextHead, new TransactionalBatchItemRequestOptions { // Stream Head nur ersetzen, wenn er seit dem Lesen unverändert ist. IfMatchEtag = currentHeadEtag });using TransactionalBatchResponse response = await batch.ExecuteAsync(cancellationToken);if (!response.IsSuccessStatusCode){ throw new InvalidOperationException( $"Transactional Batch fehlgeschlagen: {response.StatusCode}");}
Bei einem fehlgeschlagenen Batch wird der Command nicht als erfolgreich bestätigt.
Der aufrufende Handler muss den Fehler je nach Ursache behandeln; der Ausschnitt zeigt weder eine Wiederholungsstrategie noch eine nutzerseitige Fehlermeldung.
Wie der Handler auf Konflikte und Timeouts reagiert, sehen wir uns im nächsten Abschnitt an.
Modellklassen und vorheriges Laden sind im Ausschnitt ausgelassen.
nextEvent und nextHead müssen dieselbe aggregateId enthalten und mit den Cosmos-Eigenschaften id und aggregateId serialisiert werden.
Für das erste Event musst du den Stream Head im Batch neu anlegen, statt ihn zu ersetzen.
Gleichzeitige und wiederholte Schreibversuche behandeln
Hat ein anderer Command den Stream Head seit dem Lesen geändert, stimmt der gelesene ETag nicht mehr mit dem aktuellen Dokument überein.
Cosmos DB weist den Batch deshalb mit 412 Precondition Failed zurück.
Der Handler muss den Stream neu laden und die Geschäftsregel noch einmal prüfen.
Die Änderung unverändert erneut zu schreiben, wäre falsch, weil sie auf einem veralteten Stand beruht.
Wie der ETag-Mechanismus funktioniert, erläutert die Dokumentation zu Optimistic Concurrency Control.
Bei einem erneuten Command bleibt die commandId gleich.
Der Handler muss prüfen, ob diese Kennung bereits in einem Event des Aggregates gespeichert ist, und in diesem Fall das bereits erreichte Ergebnis zurückgeben.
Sonst kann ein Retry nach einem erfolgreichen Write ein zweites fachliches Event erzeugen.
Diese Deduplizierung ist im Ausschnitt nicht enthalten.
Bei einem Timeout mit unklarem Ausgang oder 409 Conflict liest der Handler das Dokument mit der geplanten Event-ID erneut.
Er darf den Schreibversuch nur dann als bereits erfolgreich behandeln, wenn auch commandId, Typ, Version und Inhalt übereinstimmen.
Die allgemeine Exception im Ausschnitt reicht für diese Fehlerbehandlung nicht aus.
Aus Events eine Auftragsliste aufbauen
Der einzelne Auftrag lässt sich mit diesem Schreibpfad atomar speichern und aus den Events rekonstruieren.
Für eine Auftragsliste nach Status jedes Mal alle Streams zu laden, wäre jedoch aufwendig.
Deshalb speichern wir den aktuellen Wartungsstatus und die Zahl der Teilewechsel je Auftrag in einem eigenen Read Model, also einem für Abfragen optimierten Datenmodell.
Eine solche aus den Events abgeleitete Sicht nennt sich Projection.
Der Change Feed von Cosmos DB stellt neue oder geänderte Dokumente zur Verarbeitung bereit.
Ein laufender Change Feed Processor liest daraus unsere neu angelegten Event-Dokumente und aktualisiert die Projection asynchron.
Zusätzlich zum Read Model braucht er einen Lease-Container, um Zuständigkeiten und Verarbeitungsfortschritt zu verwalten.
Die Dokumentation zum Change Feed erläutert diese Verarbeitung.
Event und Stream Head werden innerhalb derselben logischen Partition atomar geschrieben.
Die Projection wird erst danach aktualisiert und ist nicht die maßgebliche Datenquelle.
Stand der Projection sicher fortschreiben
Über Partition Keys hinweg garantiert der Change Feed keine globale Reihenfolge.
Auch Änderungen aus demselben Transactional Batch können in beliebiger Reihenfolge eintreffen.
Filtere deshalb die Stream Heads über kind heraus und ordne die Events nach ihrer Aggregate-Version.
Der Change Feed Processor verarbeitet Events mindestens einmal.
Nach einem Fehler kann dasselbe Event deshalb erneut eintreffen.
Die Verarbeitung muss idempotent sein, darf das Ergebnis bei einer Wiederholung also nicht noch einmal verändern.
Unsere Funktion überspringt bereits angewendete Versionen und weist auf eine Lücke im Event Stream hin.
Wir speichern die Projection mit einem Dokument je Auftrag.
Bei einer neuen Projection beginnt LastAppliedVersion mit 0, damit ein Event mit Version 1 als erstes angewendet wird.
Der Ausschnitt lässt die Modelltypen aus.
MaintenanceProjection ist ein C#-Record.
Vor dem Aufruf muss der Handler sicherstellen, dass er Events des passenden Auftrags verwendet und ihre Schema-Versionen verarbeiten kann.
MaintenanceProjection ApplyEvent( MaintenanceProjection current, MaintenanceEvent item){ if (item.Version <= current.LastAppliedVersion) { return current; // Bereits angewendet, keine erneute Änderung. } if (item.Version != current.LastAppliedVersion + 1) { throw new InvalidOperationException("Stream-Version fehlt."); } var status = item.Type switch { "MaintenanceScheduled" => "scheduled", "PartReplaced" => current.Status, "MaintenanceCompleted" => "completed", _ => throw new NotSupportedException(item.Type) }; return current with { Status = status, PartReplacementCount = current.PartReplacementCount + (item.Type == "PartReplaced" ? 1 : 0), LastAppliedVersion = item.Version };}
Damit die Versionsprüfung auch bei Wiederholungen funktioniert, muss der aufrufende Handler den Zustand der Projection und LastAppliedVersion gemeinsam im selben Dokument speichern.
Konkurrierende Updates sichert er per ETag ab.
Der Ausschnitt berechnet nur den neuen Zustand.
Das Laden und konfliktgesicherte Speichern muss der Handler übernehmen.
Bei einem ETag-Konflikt lädt der Handler die Projection erneut und wendet das Event anhand des aktuellen Versionsstands an.
Fehlen eine oder mehrere Versionen, muss der Handler die fehlenden Events in Reihenfolge aus dem Event Store nachladen, bevor er ein Event mit höherer Version anwendet.
Sonst würde die Prüfung im Beispiel die Verarbeitung blockieren.
Erst nach erfolgreicher Speicherung darf der Handler zurückkehren und so den Fortschritt bestätigen.
Verzögerungen in der Oberfläche berücksichtigen
Nach einem erfolgreichen Command kann das Read Model trotzdem noch den alten Stand zeigen.
Der Wartungsauftrag ist dann bereits abgeschlossen, während die Liste ihn noch als offen anzeigt.
Du kannst den bestätigten Zustand direkt aus dem Schreibpfad zurückgeben oder in der Oberfläche anzeigen, dass die Aktualisierung noch aussteht.
Was bei Wachstum und Betrieb hinzukommt
Streams und Projections langfristig betreiben
Je länger ein Stream wird, desto aufwendiger wird seine Rehydration.
Ein Snapshot kann sie verkürzen, indem er einen abgeleiteten Zwischenstand zusammen mit der Stream-Version speichert.
Die Anwendung lädt dann nur noch die Events nach diesem Zwischenstand nach.
Die vollständige Historie bleibt trotzdem nötig, um den Zustand unabhängig vom Snapshot wiederherstellen zu können.
Auch bei Änderungen am Event-Schema muss die Anwendung alte Events noch lesen können.
Mit Upcasting wandelst du ältere Formate beim Lesen in eine von der aktuellen Verarbeitung unterstützte Form um.
Die schemaVersion im Event-Dokument hilft dabei, die Formate zu unterscheiden.
Für neue Funktionen und beim Neuaufbau einer Projection brauchst du deshalb auch Tests mit alten Events.
Wenn du die Historie erneut verarbeitest, um eine Projection neu aufzubauen, spricht man von einem Replay.
Die Quelle dafür sind unsere unveränderten Event-Dokumente, nicht eine Versionshistorie des Change Feeds.
Dabei dürfen bereits ausgeführte externe Aktionen wie Benachrichtigungen nicht noch einmal ausgelöst werden.
Dein Team muss die Verzögerung laufender Projections überwachen und ihren Neuaufbau auch unter Zeitdruck beherrschen.
Grenzen des Cosmos-DB-Modells einplanen
Ein Aggregate entspricht in unserem Modell einer logischen Partition.
Mehrere Wartungsaufträge oder einen zusätzlichen Container kannst du deshalb nicht mit einem Transactional Batch atomar ändern.
Die Dokumentation zu Transactional Batch nennt maximal 100 Operationen, 2 MB Request-Größe und fünf Sekunden Ausführungszeit pro Batch.
Ein Batch eignet sich damit für eine begrenzte fachliche Transaktion, nicht für einen beliebig großen Gesamtprozess.
Ein einzelner Stream kann auch nicht beliebig groß oder schreibintensiv werden.
Für das hier verwendete einfache Partitionierungsmodell nennt die Cosmos-DB-Dokumentation zur Partitionierung maximal 20 GB je logischer Partition und eine Durchsatzobergrenze von 10.000 Request Units pro Sekunde (RU/s).
Der tatsächlich verfügbare Durchsatz hängt außerdem vom Betriebsmodell und dem bereitgestellten Budget ab.
So kann ein besonders aktiver Auftrag zum Engpass werden, obwohl der Container insgesamt noch Kapazität hat.
Den Partition-Key-Pfad kannst du an einem bestehenden Container nicht einfach ändern.
Für ein anderes Modell brauchst du eine Migration.
Mehr zu den Grundlagen findest du in unserem Artikel Cosmos DB Partitionierung richtig gemacht.
Cosmos DB übernimmt die Datenbankoperationen, aber die Regeln für Versionierung, Schemaentwicklung, Wiederholungen und Replay musst du selbst umsetzen.
Personenbezogene Daten begrenzen
Bei personenbezogenen Daten stellt sich die Frage, wie du Löschanforderungen mit einer unveränderlichen Historie vereinbarst.
Kläre früh, welche Daten überhaupt in die Events gehören.
Du kannst Daten auslagern und nur Referenzen speichern, allerdings können auch diese personenbezogen sein.
Event Sourcing allein sorgt weder für Revisionssicherheit noch für eine datenschutzkonforme Historie.
Diese Einschränkungen findest du auch in Microsofts Problemen und Überlegungen zum Event Sourcing.
Wann sich der Aufwand lohnt
Solange aktueller Status und Audit-Log für unseren Wartungsauftrag ausreichen, bleibt die zustandsbasierte Speicherung meist einfacher.
Auch die Rekonstruktion vor einer Korrektur ist allein noch kein Grund für Event Sourcing, wenn eine vollständige Historie diese Anforderung bereits erfüllt.
Der Ansatz wird dann interessant, wenn deine Fachlogik auf dem Event Stream aufbauen soll und du daraus passende Zustände oder weitere Read Models ableiten willst.
Was du in den ursprünglichen Events nicht gespeichert hast, fehlt dir allerdings auch später bei der Auswertung.
Die ganze Anwendung musst du dafür nicht umstellen.
Du kannst Wartungsaufträge eventbasiert speichern und Stammdaten weiterhin als aktuelle Datensätze halten.
Prüfe auch, ob dein Team Schemaentwicklung, Projection-Betrieb und Fehlerbehandlung dauerhaft abdecken kann.
Probiere den Ansatz zunächst an einem passenden Aggregate aus.
Teste zwei gleichzeitige Commands, einen Timeout nach erfolgreichem Schreiben, doppelte Verarbeitung und den vollständigen Neuaufbau einer Projection.
Miss unter der erwarteten Last, wie groß die Streams werden, was die Rehydration kostet und wie weit das Read Model hinterherhinkt.
An diesen Ergebnissen kannst du beurteilen, ob der Aufwand für deinen Anwendungsfall gerechtfertigt ist.
Wie entscheidest du, ob die Änderungshistorie in deinem System fachlichen Wert hat? Schau gerne bei uns auf LinkedIn vorbei und diskutiere mit.
Felix ist Solution Architect mit Fokus auf skalierbare Azure-IoT-Lösungen, agile Entwicklungsprozesse und DevOps. Er verbindet tiefes technisches Verständnis mit pragmatischer Umsetzung und schafft so nachhaltigen Geschäftsnutzen.
Braucht jede Azure-Umgebung Hub-and-Spoke, zentrale Security-Subscriptions und eine Plattformorganisation? Oft nicht. Wir zeigen, welche Landing-Zone-Prinzipien schon für kleine Teams echten Mehrwert schaffen und wann mehr Komplexität sinnvoll wird.
Azure Policy hilft dir, Plattformregeln technisch durchzusetzen, Ressourcen konsistent zu bewerten und Abweichungen früh sichtbar zu machen, ersetzt aber weder saubere Scopes noch gute Architekturentscheidungen.
REST, GraphQL oder OData? Hier erfährst du, wann welcher API-Stil die richtige Wahl für dein Projekt ist und wie du die Entscheidung pragmatisch triffst.
Wie sich das neue Azure IoT Operations von bestehenden Azure-Diensten unterscheidet, welche Technologien dabei zum Einsatz kommen und wann sich der Umstieg lohnt.
Maschinenhersteller können Software-Releases in Dependency-Track bewerten und über die Installed Base nachvollziehen, welche Version auf welcher Maschine läuft.
Azure Policy scheitert selten an der Definition selbst, sondern an zu großen Scopes, unklaren Ausnahmen und unkontrollierten Rollouts. Dieser Artikel zeigt, wie du Regeln sicher aktivierst und typische Betriebsfehler vermeidest.
Wer Azure Policy im größeren Maßstab betreibt, kommt um Policy as Code kaum herum. Definitionen, Initiatives, Assignments und Ausnahmen sollten gemeinsam versioniert und als konsistentes Regelwerk verwaltet werden.
 Felix BurkhardSolution Architect