Abhängigkeiten bleiben unklar
Niemand kann das Gesamtsystem und seine wichtigsten Abhängigkeiten erklären.
Solange eine Anwendung ihre Kernaufgaben erfüllt, erscheint ihre Modernisierung vielen Unternehmen als aufschiebbares Thema. Die größten Probleme zeigen sich oft an anderer Stelle. Wenn kritisches Wissen nur unvollständig dokumentiert ist, Änderungen immer länger dauern und Sicherheitsupdates regelmäßig verschoben werden, wird aus einer ehemals erfolgreichen Anwendung schleichend ein Geschäftsrisiko.
Legacy wird nicht durch das Alter der Software zum Problem, sondern dann, wenn Änderbarkeit, Betrieb, Wissen und Risiken nicht mehr beherrschbar sind.
Für eine erste Risikoeinschätzung helfen vier Fragen: Wie lange dauert eine typische Änderung? Wer kann einen kritischen Ablauf im Betrieb erklären? Wie sicher ist das System, und welcher Aufwand ist nötig, um es sicher zu halten? Und welche Folgen hätte ein Ausfall für den Betrieb? Für eine Modernisierungsentscheidung müssen zusätzlich Geschäftsziele, Kosten, Abhängigkeiten und das gewünschte Zielbild betrachtet werden.
Stell dir eine Anwendung vor, die seit 15 Jahren im Unternehmen läuft. Sie unterstützt täglich wichtige Abläufe. Die Nutzer kennen ihre Eigenheiten, und ein Ausfall wäre schwerwiegend. Jeder Vorschlag zur Ablösung löst deshalb zunächst dieselbe Reaktion aus: Das System läuft doch noch.
Genau darin liegt die Schwierigkeit. Solange die Anwendung ihre Kernaufgabe erfüllt, gibt es selten einen einzelnen Vorfall, der eine Modernisierung zwingend auslöst. Stattdessen wird die Entscheidung von Quartal zu Quartal verschoben, weil das kurzfristige Risiko einer Änderung sichtbarer ist als die schleichenden Kosten des Weiterbetriebs.
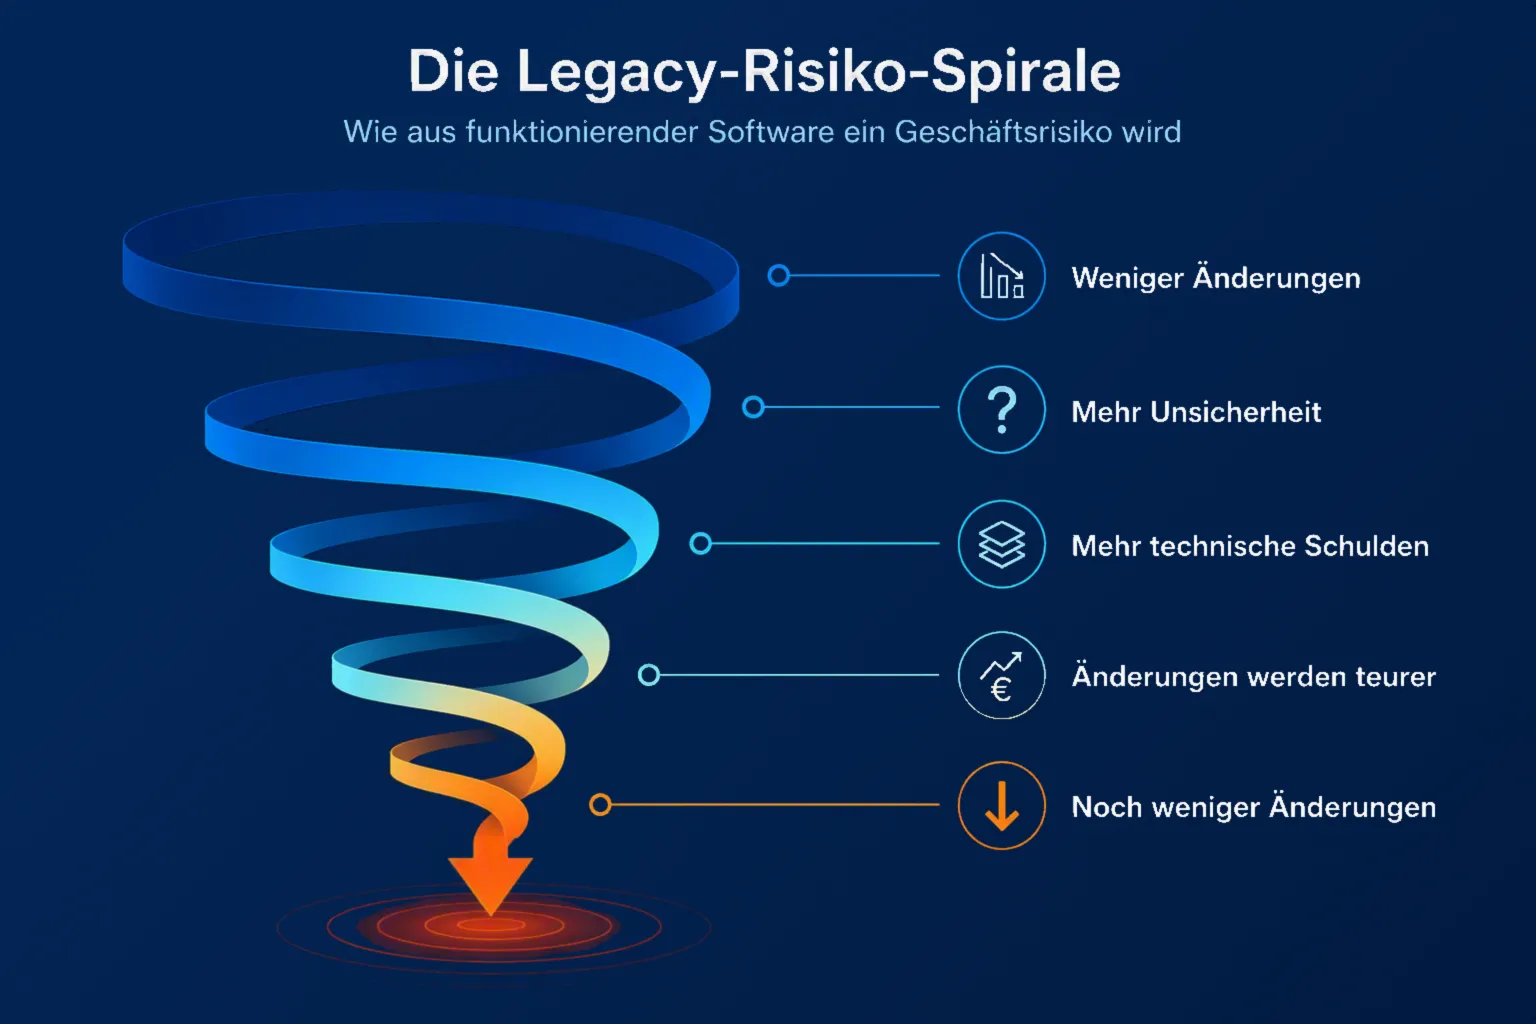
Die Spirale zeigt, warum sich Legacy-Risiken selbst verstärken. Die Spirale beginnt, wenn Änderungen als riskant erscheinen und deshalb verschoben werden. Dadurch gehen Wissen und Routine verloren, die Unsicherheit steigt und die nächste Änderung wird aufwendiger. Das bestätigt wiederum den Eindruck, dass weitere Eingriffe besser vermieden werden. So verstärkt sich der Kreislauf selbst: Jede Verschiebung erhöht das Risiko der nächsten Änderung.
Der Begriff Legacy-System beschreibt dabei nicht einfach alte Software. Gemeint ist meist ein gewachsenes System, dessen Ablösung oder Veränderung wegen Abhängigkeiten, fehlendem Wissen oder einer veralteten Plattform besonders schwierig ist. Diese Abhängigkeiten entstehen typischerweise in der Technik, bei Daten und Integrationen oder in Prozessen. Ein nicht mehr unterstütztes Betriebssystem, ein undokumentiertes Datenformat oder eine manuelle Übergabe zwischen zwei Anwendungen können jeweils eine Änderung blockieren.
Alter allein macht Software nicht unwirtschaftlich. Eine stabile Anwendung mit klarer Dokumentation, verfügbaren Experten, beherrschbaren Abhängigkeiten und angemessenen Sicherheitsprozessen kann noch lange wirtschaftlich sein. Auch eine neue Anwendung ist nicht modern, wenn sie schwer testbar ist, keine klare Verantwortung hat oder jede Änderung manuelle Sonderarbeit erfordert.
Entscheidend ist daher nicht das Alter der Technologie, sondern wie planbar das System verändert und betrieben werden kann. Kritisch wird es, wenn jede Änderung Angst macht, Deployments nur außerhalb der Arbeitszeit möglich sind oder niemand zuverlässig sagen kann, welche Nebenwirkungen eine scheinbar kleine Anpassung auslöst.
Die Kosten eines Legacy-Systems stehen selten als eigene Position in der Gewinn- und Verlustrechnung. Sie verteilen sich auf längere Durchlaufzeiten, zusätzliche Abstimmungen, teure Störungen und Arbeitszeit, die nicht für neue Geschäftsfunktionen zur Verfügung steht. Mehrere Muster machen diese Kosten sichtbar.
In manchen gewachsenen Systemen gibt es eine Person, die weiß, warum ein Hintergrundjob in einer bestimmten Reihenfolge laufen muss, welche manuellen Schritte nach einem Fehler nötig sind und wo eine kleine Änderung andere Prozesse beeinflusst.
Dieses Wissen ist wertvoll, aber als alleinige Absicherung gefährlich. Bleibt es an eine Person gebunden, wird diese schnell zum Flaschenhals: Projekte warten auf ihre Einschätzung, ihre Belastung steigt und damit auch das Fluktuationsrisiko. Fällt sie aus, geht weiteres Wissen verloren und die Betriebsfähigkeit sinkt. Fehlende Dokumentation verschärft das Problem: Entscheidungen hängen dann von informellen Auskünften ab.
Manuelle Deployments, lokale Skripte und individuelle Checklisten können anfangs pragmatisch sein. Problematisch werden sie, wenn niemand den vollständigen Ablauf kennt oder ein Rollback, also die Rückkehr auf eine vorherige Version, nur mit Unterstützung einer bestimmten Person gelingt. Dann hängt die Verfügbarkeit des Systems von Aufmerksamkeit, Erfahrung und Bereitschaft zu Arbeit außerhalb der normalen Betriebszeiten ab.
Ein reproduzierbarer Build, automatisierte Tests und ein regelmäßig erprobter Rollback reduzieren diese Abhängigkeit von Einzelpersonen.
In einer schwer verständlichen Anwendung ist die eigentliche Programmierarbeit oft nicht der größte Aufwand. Das Team muss zuerst Zusammenhänge, betroffene Daten und bisherige manuelle Tests rekonstruieren.
Hohe Änderungskosten verstärken diese Spirale. Teams bündeln Anforderungen, weil einzelne Änderungen zu aufwendig wirken. Das kann bei aufwendigen Deployments, etwa mit Produktionsstillstand oder Rezertifizierung, sinnvoll sein. Werden Deployments ohne diese Notwendigkeit größer, steigt jedoch das Risiko und Feedback kommt später. Wenn Probleme erst spät sichtbar werden, wird die nächste Änderung noch schwieriger. Ein kleines Feld in einer Maske kann dadurch mehr Aufwand verursachen als ein komplettes Feature in einem gut strukturierten System.
Hilfreich ist ein begrenzter erster Schritt: Betroffene Abläufe und Datenflüsse vor der Änderung festhalten, kritisches Verhalten automatisiert testen und den Umfang der Änderung klein halten. So lässt sich die Unsicherheit schrittweise reduzieren, ohne den Betrieb mit einem großen Umbau zu belasten.
Technische Schulden entstehen, wenn kurzfristige Entscheidungen spätere Änderungen, den Betrieb oder die Absicherung verteuern. Typische Ursachen sind fehlende Tests, manuelle Deployments, veraltete Komponenten, unklare Datenflüsse sowie wachsende Komplexität und enge Kopplung. Nicht das Alter einer Lösung ist entscheidend, sondern ob das Team ihre Folgen noch beherrscht.
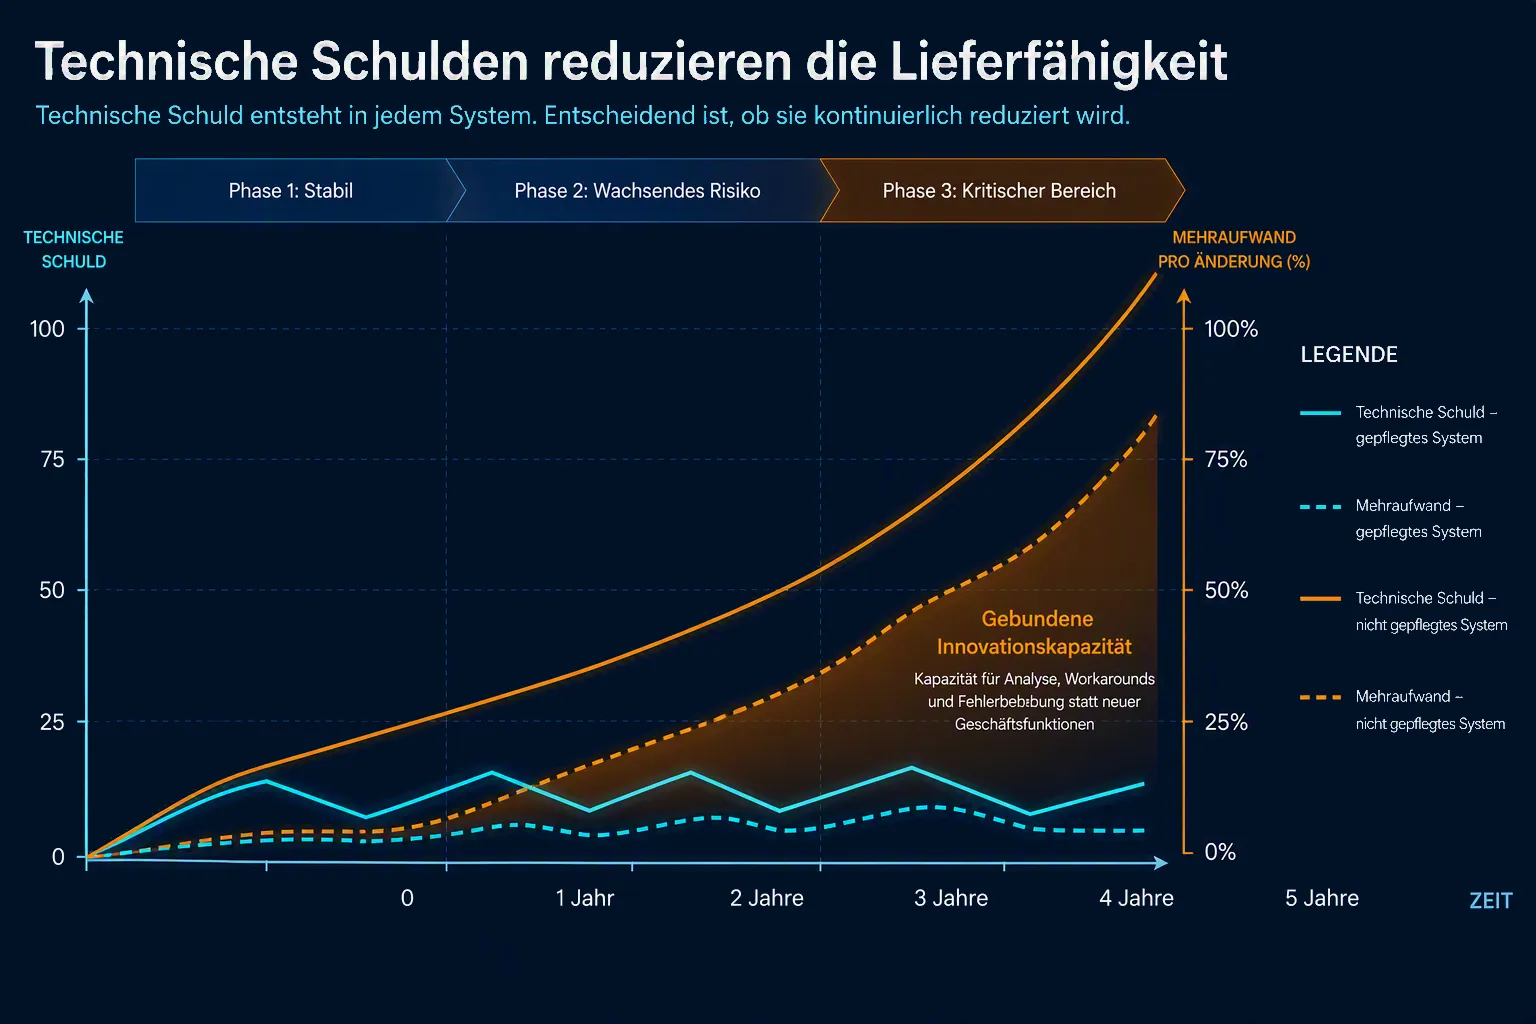
Die Grafik zeigt den Unterschied zwischen gepflegten und ungepflegten Systemen: Technische Schulden können in jedem System entstehen. Werden Tests, Dokumentation, Abhängigkeiten und Releaseweg kontinuierlich gepflegt, bleiben Schuld und Mehraufwand begrenzt. Werden diese Maßnahmen verschoben, steigen beide mit jeder Änderung. Ein wachsender Teil der Kapazität fließt dann in Fehlerbehebung und Workarounds statt in neue Geschäftsfunktionen.
Vor einer größeren Änderung sollte das Team kritisches Verhalten testen, betroffene Abhängigkeiten und Datenflüsse dokumentieren und notwendige Updates einplanen. Diese begrenzte Tilgung sollte mit jeder Änderung und regelmäßig im Betrieb fortgeführt werden. So bleibt die technische Schuld sichtbar und beherrschbar, statt zur dauerhaften Belastung zu werden.
Sichtbar wird sie durch Kennzahlen wie Durchlaufzeit je Änderung, Häufigkeit von Störungen, Aufwand für manuelle Nacharbeiten und Zeit bis zur Wiederherstellung. Die Werte müssen nicht auf die Minute genau sein; schon ein regelmäßiger Vergleich zeigt, ob der Aufwand steigt oder sinkt.
Viele dieser Kosten tauchen in keiner Rechnung auf. Wenn Experten ihre Zeit in Sonderarbeit und Störungsbehebung binden, verzögern sich Markteinführungen, Anforderungen bleiben liegen, Automatisierung wird nicht umgesetzt und Geschäftschancen gehen verloren. Bei der Bewertung sollten sie deshalb neben Lizenzen, Wartung und Vorfällen berücksichtigt werden. Entscheidend ist auch, was das Unternehmen wegen des Bestands nicht schafft.
Legacy kann in Prozessen, Excel-Dateien, Schatten-IT, Schnittstellen oder Wissensinseln entstehen. Schatten-IT entsteht etwa, wenn ein Fachbereich eine eigene Datenbank führt, weil das Kernsystem eine benötigte Auswertung nicht liefert. Schnittstellen werden zum Risiko, wenn niemand ihr Datenformat, ihre Fehlerfälle oder die Verantwortung für Änderungen kennt. Eine Excel-Datei beginnt oft als passende Lösung für ein kleines Problem, übernimmt später aber Preisberechnung, Freigaben oder Teile des Monatsabschlusses. Mit jeder weiteren Version, jedem Makro und jeder manuellen Übertragung verteilt sich die Geschäftslogik weiter. Abhängigkeiten nehmen zu, Transparenz sinkt und eine spätere Modernisierung wird schwieriger, weil Regeln und Daten nicht mehr an einer Stelle nachvollziehbar sind. Excel ist daran nicht schuld. Zum Risiko wird die Lösung, wenn ein nicht versionierter und nicht getesteter Prozess geschäftskritisch wird, ohne Verantwortliche, Zugriffsschutz oder Wiederherstellung.
Dass ein Framework alt ist, reicht in vielen Unternehmen noch nicht für ein Investitionsprojekt. Dringlich wird Modernisierung, wenn Software konkrete Geschäftsziele behindert oder ein Risiko nicht mehr vertretbar ist.
Fehlende Experten machen Modernisierung dringlicher. Für eine seltene Programmiersprache oder ein proprietäres Framework lassen sich nicht immer kurzfristig geeignete Fachkräfte gewinnen. Eine verbreitete Plattform kann die Personalsuche erleichtern, löst den Engpass aber nicht, wenn Architektur, Dokumentation und Entwicklungsprozess weiter vom Spezialwissen einzelner Personen abhängen.
Sicherheit und Compliance machen verborgene Risiken sichtbarer. Nicht mehr unterstützte Frameworks, veraltete Betriebssysteme oder nicht behebbare Schwachstellen sind nicht bloß technische Schönheitsfehler. Je nach Branche gelten Anforderungen an Patchprozesse, Komponenten-Inventare und Verantwortlichkeiten. Keine dieser Anforderungen schreibt pauschal eine bestimmte Programmiersprache vor. Ohne Patchprozess, Komponenten-Inventar und klare Zuständigkeiten lässt sich ein System jedoch schwer dauerhaft sicher betreiben und prüfen. Wenn eine Komponente nicht mehr patchbar ist, werden kompensierende Maßnahmen notwendig. Dadurch steigen Betriebs- und Nachweisaufwand, und Audits, Kundenanforderungen oder Produktfreigaben werden schwieriger. So wird aus einer technischen Altlast ein konkretes Geschäftsrisiko. Der Cyber Resilience Act (CRA) und NIS2 zeigen, warum das wichtig ist: Je nach Produkt und Organisation werden Sicherheitsupdates, Verantwortlichkeiten und Risikomanagement zu konkreten Anforderungen. Eine Modernisierung ist dadurch nicht automatisch vorgeschrieben, aber fehlende Updatefähigkeit wird schwerer zu rechtfertigen.
Auch Kosten und Wachstum verändern die Rechnung. Teure Wartungsverträge, proprietäre Lizenzen oder Spezialhardware fallen stärker ins Gewicht, wenn Nutzerzahlen, Datenmengen oder Integrationen wachsen. Vor einer Modernisierung sollte deshalb getrennt werden: Welche Kosten entstehen in Entwicklung und Betrieb durch die Technologie, welche durch ineffiziente Prozesse oder fehlende Transparenz? Ein Framework kann die Entwicklung beschleunigen und dennoch durch Laufzeitlizenzen für jedes Deployment hohe Betriebskosten verursachen.
Die bestehende Plattform kann außerdem neue Geschäftsfunktionen bremsen. Automatisierte Abläufe, Auswertungen oder Funktionen für Fachbereiche scheitern oft an fehlenden Schnittstellen, zugänglichen Daten oder einem sicheren Weg, neue Funktionen neben dem Bestand zu betreiben. Das ist ein Geschäftsproblem, auch wenn die Anwendung selbst noch keinen Fehler meldet.
Ein Technologiewechsel kann notwendig sein. Wer eine Anwendung aus Visual Basic 6 auf .NET portiert, kann damit Support- und Plattformrisiken reduzieren. Eine Weboberfläche kann neue Integrations- und Nutzungsmöglichkeiten eröffnen, während eine native Oberfläche bei komplexen oder performancekritischen Szenarien passend bleiben kann. Wenn Prozesse, Datenmodell, Architektur und Testlücken unverändert bleiben, bleibt jedoch ein großer Teil des ursprünglichen Risikos bestehen.
Auch die Cloud löst diese Probleme nicht von selbst. Eine Anwendung kann dort weiterhin manuell ausgerollt werden, unklare Zuständigkeiten haben oder keine verlässliche Wiederherstellung ermöglichen. Die neue Umgebung verschiebt dann Teile des Betriebs, statt die zugrunde liegenden Probleme zu lösen, und bringt je nach Architektur neue Infrastrukturkosten und Anforderungen an Zugriffsverwaltung.
Modernisierung bedeutet deshalb nicht automatisch Rewrite. Ein vollständiger Neubau ist oft der riskanteste Weg, weil im Bestand über Jahre gewachsenes Fachwissen und Verhalten erst wieder verstanden werden müssen. Sinnvoller ist häufig, bewährte Teile gezielt weiterzuverwenden und schrittweise zu verbessern: veraltete oder besonders riskante Komponenten werden zuerst ersetzt, während der Rest weiterläuft. Vor der Umsetzung sollte das Team die kritischen Geschäftsprozesse, Abhängigkeiten, Schnittstellen und Datenflüsse festhalten. Danach sollte es entscheiden, welche Risiken zuerst sinken müssen und welches Verhalten für Nutzer unverändert bleiben soll.
Dafür braucht es Dokumentation, automatisierte Tests, eine klare Architektur, einen reproduzierbaren Releaseweg sowie Anforderungen an Sicherheit und Betrieb. Eine schrittweise Modernisierung kann diese Verbesserungen mit Feedback aus dem laufenden Betrieb verbinden, braucht aber klare Grenzen und Prioritäten.
Ein einzelnes Warnsignal beweist noch keinen Modernisierungsbedarf. Mehrere der folgenden Beobachtungen über längere Zeit sind jedoch ein guter Anlass für eine strukturierte Bewertung:
Abhängigkeiten bleiben unklar
Niemand kann das Gesamtsystem und seine wichtigsten Abhängigkeiten erklären.
Kritische Regeln sind ungetestet
Es gibt keine automatisierten Tests für wichtige Geschäftsregeln.
Deployments brauchen Sonderzeiten
Deployments finden bevorzugt außerhalb der Arbeitszeit statt.
Kleine Änderungen wachsen
Eine kleine Anpassung braucht immer länger oder wird regelmäßig verschoben.
Updates werden zurückgestellt
Sicherheitsupdates werden wegen befürchteter Seiteneffekte verschoben.
Excel ergänzt das Kernsystem
Excel-Dateien oder manuelle Listen übernehmen fehlende Funktionen.
Die Plattform bremst Anforderungen
Neue Anforderungen werden wegen der Plattform immer wieder vertagt.
Backup und Restore bleibt ungeprüft
Niemand weiß sicher, ob Backups und Restores im Ernstfall funktionieren.
Keines dieser Signale ist für sich ein pauschales Urteil. Ein manuelles Verfahren kann für einen seltenen, unkritischen Prozess angemessen sein, während ein automatisierter Ablauf ohne Überwachung ein größeres Risiko darstellt. Ordne deshalb jedes Signal seiner Auswirkung zu: Wie oft tritt es auf, welche Kosten entstehen und welches Geschäftsziel wird dadurch eingeschränkt?
Warnsignale sind kein Auftrag für einen vollständigen Neubau. Sie zeigen, dass die nächste Entscheidung auf Fakten statt auf Bauchgefühl beruhen sollte. Entwicklung, Betrieb und Fachbereich sollten dafür einen kritischen Ablauf gemeinsam bewerten:
Miss dabei vier Größen: Wird eine typische Änderung schneller ausgeliefert? Lässt sich ein Fehler schneller beheben? Sinkt der Aufwand für Sicherheitsupdates und manuelle Sonderarbeit? Beherrschen mindestens zwei Personen den Ablauf? Wenn diese Größen nicht besser werden, war die Maßnahme zu klein, falsch gewählt oder schlecht begrenzt. Danach lässt sich begründet entscheiden, ob der Bestand stabilisiert, schrittweise modernisiert oder eine Komponente beziehungsweise das gesamte System ersetzt wird.
Wie lange dauert bei dir eine kleine Änderung, und wer kann sie im Störungsfall übernehmen? Wir übernehmen die Modernisierung gerne. Sprich uns an.
Florian ist Solution Architect und Microsoft Most Valuable Professional (MVP) für Azure & Azure IoT mit langjähriger Erfahrung im Bereich DevOps, Cloud und Digitalisierung. Er unterstützt Unternehmen dabei, effiziente und effektive Lösungen zu entwickeln, die ihre digitalen Projekte nachhaltig zum Erfolg führen.
Weitere Artikel zu ähnlichen Themen.